【SAP BTP】CAPでアプリを作り、pushしたら自動デプロイされるまでを一通り
目次
はじめに
SAP BTP(Business Technology Platform)は、名前は聞くけれど実際に何をどう作るのかが見えにくいプラットフォームです。ドキュメントを読んでも、CAP・CDS・MTA・XSUAA と略語が並ぶばかりで、全体像がつかめません。
そこで、一番小さくて、しかも全部の要素が入るアプリを作ることにしました。題材は「今日のランチどこ行く?」を投票で決めるアプリです。データを持って、画面があって、ログインが要って、クラウドにデプロイされる。BTPの主要な部品を一通り通せます。
抱えていた課題
- BTPの全体像がつかめない: 部品の名前は知っていても、どれとどれがどう繋がるのかが分からない。
- 手動デプロイが面倒: 変更のたびにビルドしてアップロードするのでは、試行錯誤が続きません。
- Fiori画面の作り方が独特: 画面をコードで書くのではなく、アノテーションで宣言するという発想に馴染みがない。
作ったものの概要
技術スタックは次の通りです。
- CAP (Cloud Application Programming Model) / Java — SapMachine JDK
- OData V4 サービス + Fiori elements 画面(アノテーション駆動)
- SAP HANA Cloud(HDIコンテナ)
- XSUAA(認証)+ Application Router
- デプロイ形態は MTA(Multi-Target Application)
- CI/CDは SAP Continuous Integration & Delivery サービス(GitHub連携)
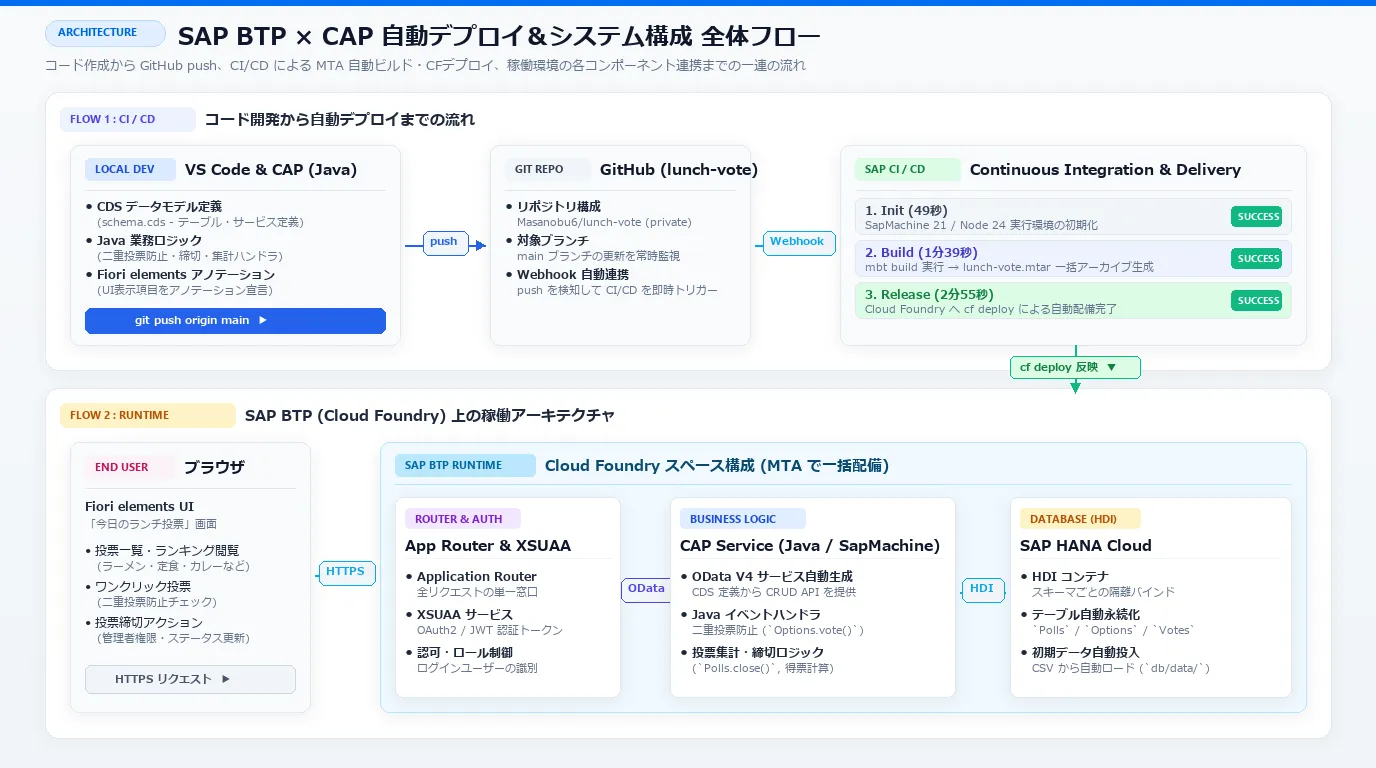
全体の構成は、上のフロー図のように大きく2つに分かれます。
- CI/CD パイプライン(自動デプロイの流れ): ローカル(VS Code)でCDSやJavaを書き、
git pushすると GitHub の Webhook 経由で SAP CI/CD サービスが自動起動。MTAビルド(mbt build)を経て Cloud Foundry へワンストップ配備されます。 - 実行環境アーキテクチャ(BTP上の稼働構成): ユーザーからのブラウザアクセスを App Router と XSUAA が受け止めて認証し、CAP Java サービス(業務ロジック・OData)へルーティング。データは HDI コンテナ経由で SAP HANA Cloud に自動永続化されます。
以下、それぞれの要素を実際にどう組み立てたのかを順に見ていきます。
1. データモデルをCDSで書き、初期データを用意する
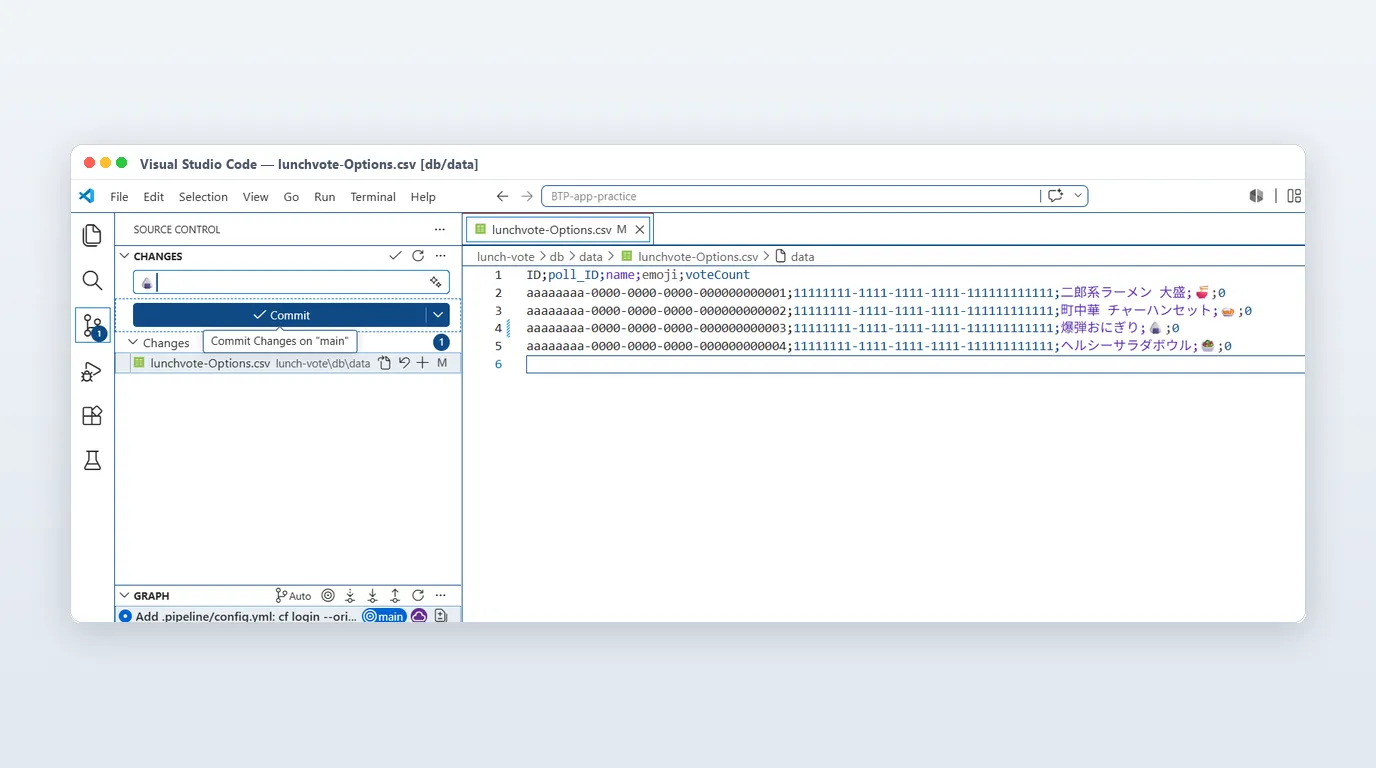
CAPでは、まずデータモデルを CDS(Core Data Services) という定義言語で書きます。SQLのテーブル定義に近いのですが、エンティティ同士の関連まで宣言で書けるのが特徴です。また、初期データ(店舗の選択肢など)も db/data/ 配下に CSV ファイルで配置しておけば、デプロイ時に自動投入されます。
今回のモデルは3つだけです。
| エンティティ | 役割 |
|---|---|
Polls | 1回の投票(タイトル・締切・クローズ状態) |
Options | 選択肢(店名やメニュー・得票数) |
Votes | 1票(投票者・対象の選択肢) |
この定義を書くと、HANA上のテーブルもOData V4のAPIも自動で生成されます。ここがCAPの一番おいしいところで、CRUDのAPIを手で書く必要がありません。
2. データベース(HANA Cloud)と業務ロジック(Java)
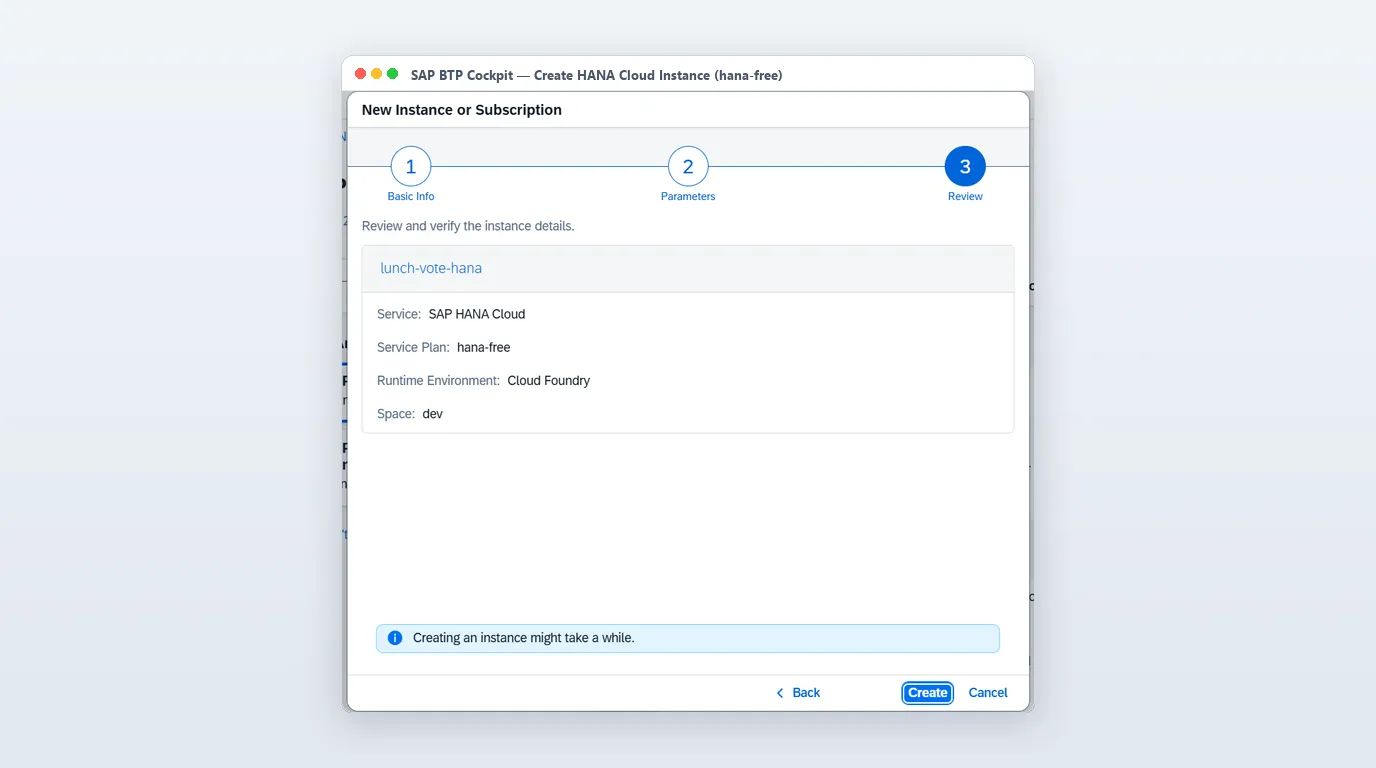
データベースには SAP HANA Cloud(hana-free プラン)を利用し、HDIコンテナ経由でバインドします。
そして、自動生成されない「業務のルール」の部分をJavaのハンドラで書きました。
Options.vote()… 締切を過ぎていないか、同じ人が二重投票していないかをチェックしてから1票を記録し、得票数を+1するPolls.close()… 投票を締め切るPollsを読むときに、総投票数を集計して返す
自動生成に任せる部分と、自分で書く部分がはっきり分かれているのが分かりやすかったです。読み書きの配管はフレームワークが持ち、ドメインのルールだけを書きます。
3. 画面はアノテーションで宣言する
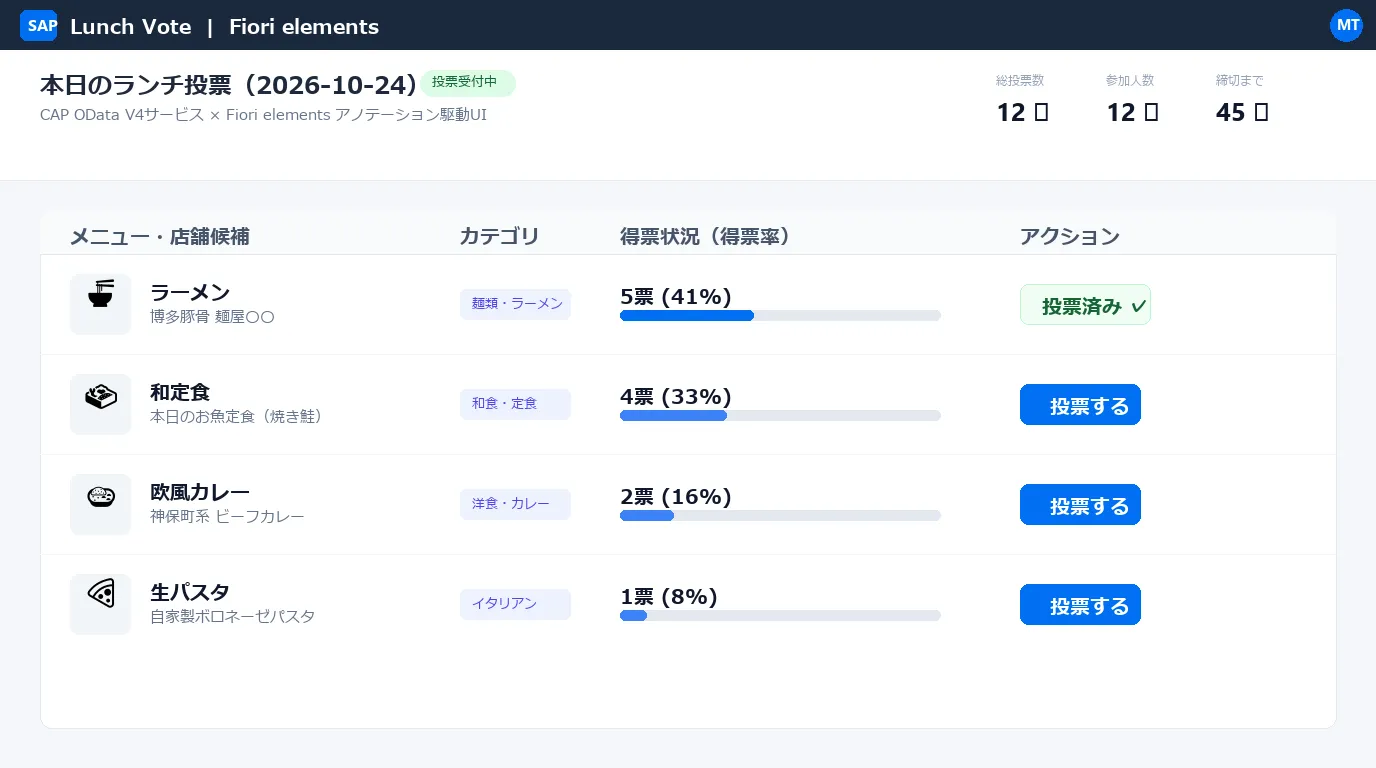
Fiori elements は、画面を1から作るのではなく、「このフィールドを一覧に出す」「これはヘッダーに出す」といった注釈をデータモデルに付けると、それに沿った画面が生成される仕組みです。
最初は違和感がありましたが、慣れると速いです。レイアウトを自分で組まないので、SAPらしい見た目が勝手に揃います。逆に、凝ったUIを作りたい場合は素直にフリースタイルで書いたほうがよさそうだ、という感触も得られました。
4. MTAでまとめてデプロイする
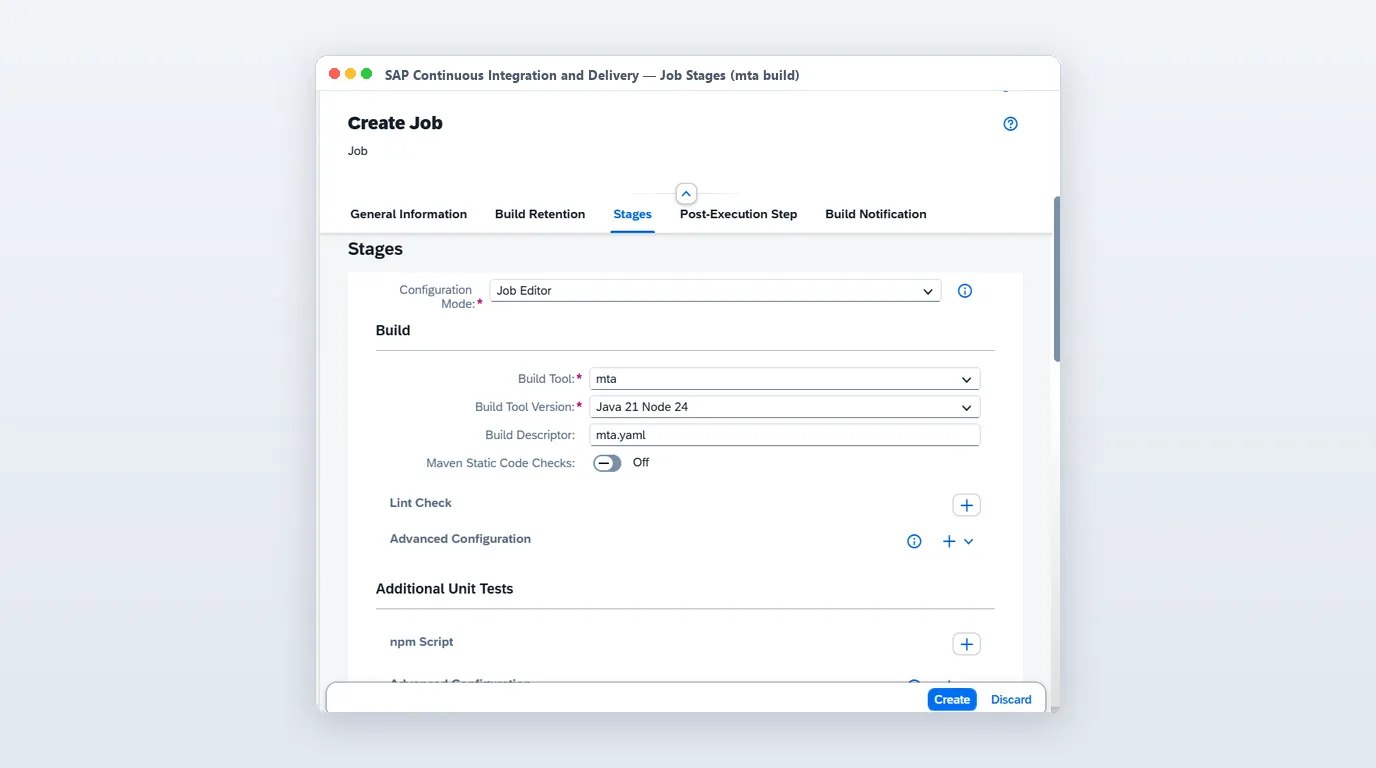
BTPへのデプロイは、アプリ単体ではなく MTA(Multi-Target Application) という単位で行います。DB(HDIコンテナ)、サービス、認証、ルーターをひとまとめにして、依存関係ごと1つのアーカイブにします。
CI/CD サービスの Job 設定でも、Build Tool に mta、実行環境に Java 21 / Node 24 を指定し、mta.yaml を元にビルドを走らせるように構成します。
cf login    # BTPのCloud Foundryエンドポイントへ
mbt build   # mtar アーカイブを生成
cf deploy mta_archives/lunch-vote_1.0.0-SNAPSHOT.mtar「アプリをデプロイする」ではなく「構成一式をデプロイする」という考え方です。DBのスキーマもここに含まれるので、環境間で構成がずれにくくなります。
5. pushしたら自動でデプロイされるようにする
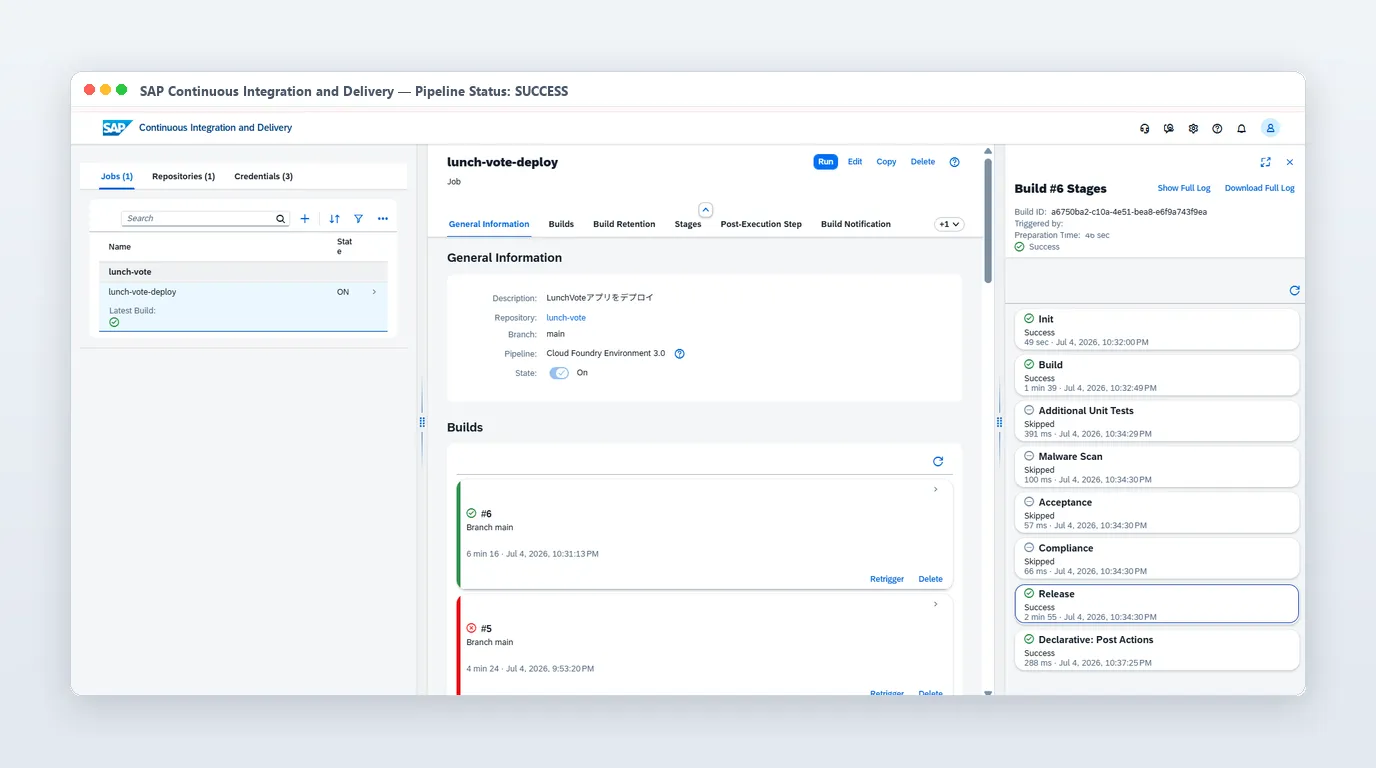
最後に、BTPコックピットの Continuous Integration & Delivery サービスでGitHubと連携させました。リポジトリにWebhookを設定し、main ブランチへのpushを検知して、ビルドからCloud Foundryへのデプロイ(Init → Build → Release)までが自動で実行されます。
実際の実行結果でも、Init(49秒)→ Build(1分39秒)→ Release(2分55秒)と各ステージが順に成功し、すべてグリーンで通過しました。
これで、コードを直してpushするだけで環境が更新される状態になりました。試行錯誤の1周が短くなると、学習の速度がまったく変わります。
使ったサービス・ツール
| サービス/ツール | 役割 | 使ってみての学び |
|---|---|---|
| SAP BTP (Cloud Foundry) | アプリの実行環境 | トライアル/無料枠で一通り試せる。サービスインスタンスの作成順に依存関係がある |
| CAP (Java) | アプリのフレームワーク | CDSを書くとテーブルとODataが自動生成される。書く量が劇的に減る |
| SAP HANA Cloud(HDIコンテナ) | データベース | スキーマもデプロイ対象。アプリと一緒にバージョン管理できる |
| Fiori elements | 画面 | アノテーション駆動。UIを書かずに一覧・詳細画面が出る |
| XSUAA + Application Router | 認証とルーティング | BTPでは事実上セットで必要。ローカル実行時とは構成が変わる |
MTA / mbt | デプロイ単位 | アプリ単体ではなく構成一式を配る、という考え方 |
| SAP Continuous Integration & Delivery | 自動デプロイ | 画面で設定でき、GitHub連携もチェックボックスで済む |
得られたメリット
BTPの部品が繋がって見えるようになった
CDS → OData → Fiori、そして MTA で束ねてデプロイ、という流れを一度通したことで、それぞれの部品が何のためにあるのかが腑に落ちました。ドキュメントを読み直したときの理解度がまるで違います。
「作って動かす」までの距離が測れた
小さいアプリなら、モデルを書いてロジックを足してデプロイするまでが現実的な時間で終わります。BTPで何かを試すコストが分かったのは大きな収穫でした。
CI/CDが標準サービスとして用意されていると知った
自前でパイプラインを組まなくても、BTPのサービスとして提供されています。既存のCI環境が無くても始められます。
まとめ
学習のために作るアプリは、小さいけれど全部の要素が入っているものを選ぶのがコツだと改めて思いました。ランチ投票は業務的には何の価値もありませんが、データ・画面・認証・デプロイ・CI/CDという、BTPで必ず通る道を全部踏めます。
次にBTPで何かを作るとき、この一周の経験がそのまま土台になります。