【Python】「英語の曲なのに日本語の愚痴に聞こえる」歌詞を機械で探す
目次
- はじめに
- 抱えていた課題
- 作った仕組みの概要
- 1. かな → 音素列 → 英単語列をビームサーチで探す
- 2. 英単語を「日本人の耳」基準に正規化する
- 3. 意味を捨てて音に振り切る
- 4. 使う単語のルールを決める
- 5. 長いフレーズは節に分割して探索する
- 6. 作曲・映像・合成から投稿までをパイプラインにする
- 7. キャラクターは「設計図」を先に作る
- チェックの仕組み紹介
- 1. Whisperで「聞こえるか」を機械的に足切りする
- 2. 距離スコアは語尾のR/Tを過大に減点する
- 得られたメリット
- 一晩かかっていた作業が数秒になった
- 品質の基準を数字で議論できるようになった
- ノウハウが積み上がるようになった
- 使ったサービス・ツール
- まとめ
はじめに
「架空労働省」というYouTubeチャンネルを運営しています。やっていることは単純で、英語の曲として聴くと普通の歌なのに、日本語耳で聞くと職場の愚痴に聞こえるショート動画を作っています。
「なんかムカつく」が None come cut, Sue coo に聞こえる、というアレです。この「空耳の逆算」を人力でやると一晩かかるので、探索の部分をPythonに任せました。
抱えていた課題
- 候補が膨大すぎて手で探せない: 「なんかムカつく」に音が近い英単語の並びは無数にあり、人間が思いつく範囲は限られています。
- 良さそうに見えても歌わせると崩れる: 文字で見て似ていても、実際に歌になると全然聞こえないことが頻繁にあります。
- 完成までの工程が多い: 歌詞を決めて、作曲して、映像を作って、合成して、字幕を焼いて、サムネを作って、アップロードする。1本作るのに手数がかかりすぎていました。
作った仕組みの概要
「機械で候補を大量に出して足切りし、最後は人間の耳で決める」という二段構えにしました。
1. かな → 音素列 → 英単語列をビームサーチで探す
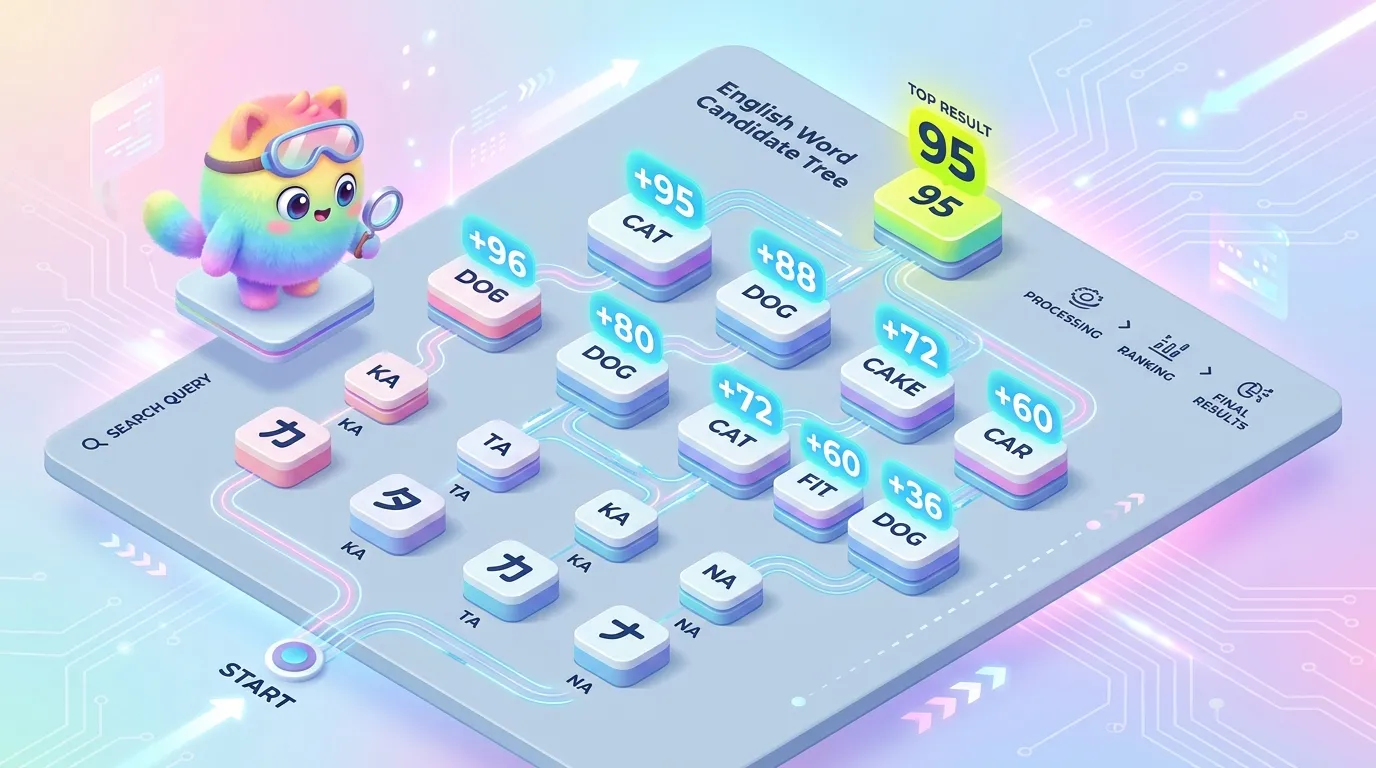
中核は soramimi.py という探索スクリプトです。処理はこうなっています。
- 日本語のかな文字列を、簡易的な音素列に変換する
- 英単語の発音辞書(CMU発音辞書)から、各単語の音素列を取り出す
- 目標の音素列に近づくように、重み付き編集距離のビームサーチで単語を並べていく
さらに、探索の途中で単語の使用頻度(Zipf頻度)を見て、実際によく使われる単語を優遇しています。そうしないと、辞書の隅にある誰も知らない単語ばかりが並んでしまうためです。
2. 英単語を「日本人の耳」基準に正規化する
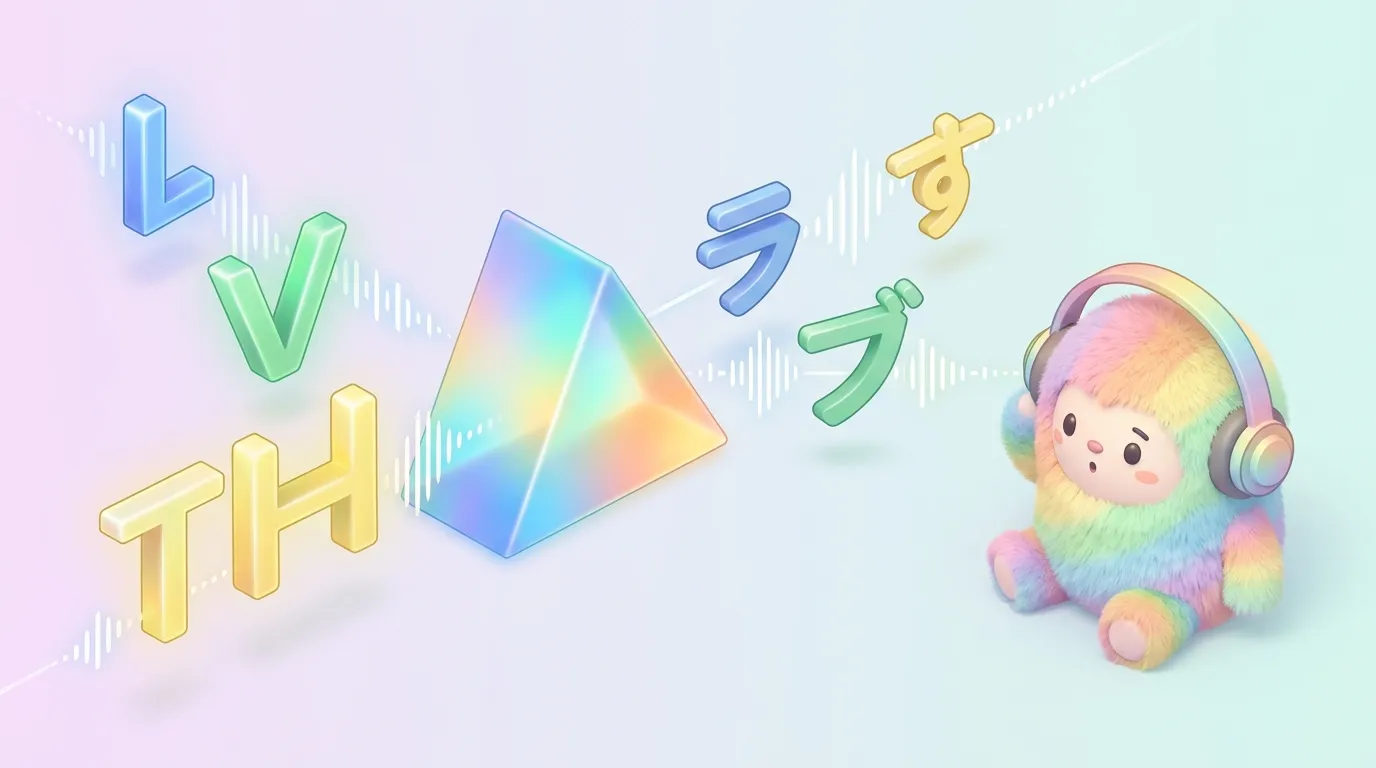
そのまま音素を比較しても、うまく当たりません。日本語話者の耳は英語の音を日本語の音に丸めて聞くからです。そこで、比較する前に英単語側の音素を次のように寄せています。
- L → R(日本語耳ではどちらもラ行)
- V → B
- TH → S
この正規化を入れてから、距離スコアが実際の聞こえ方にぐっと近づきました。
3. 意味を捨てて音に振り切る
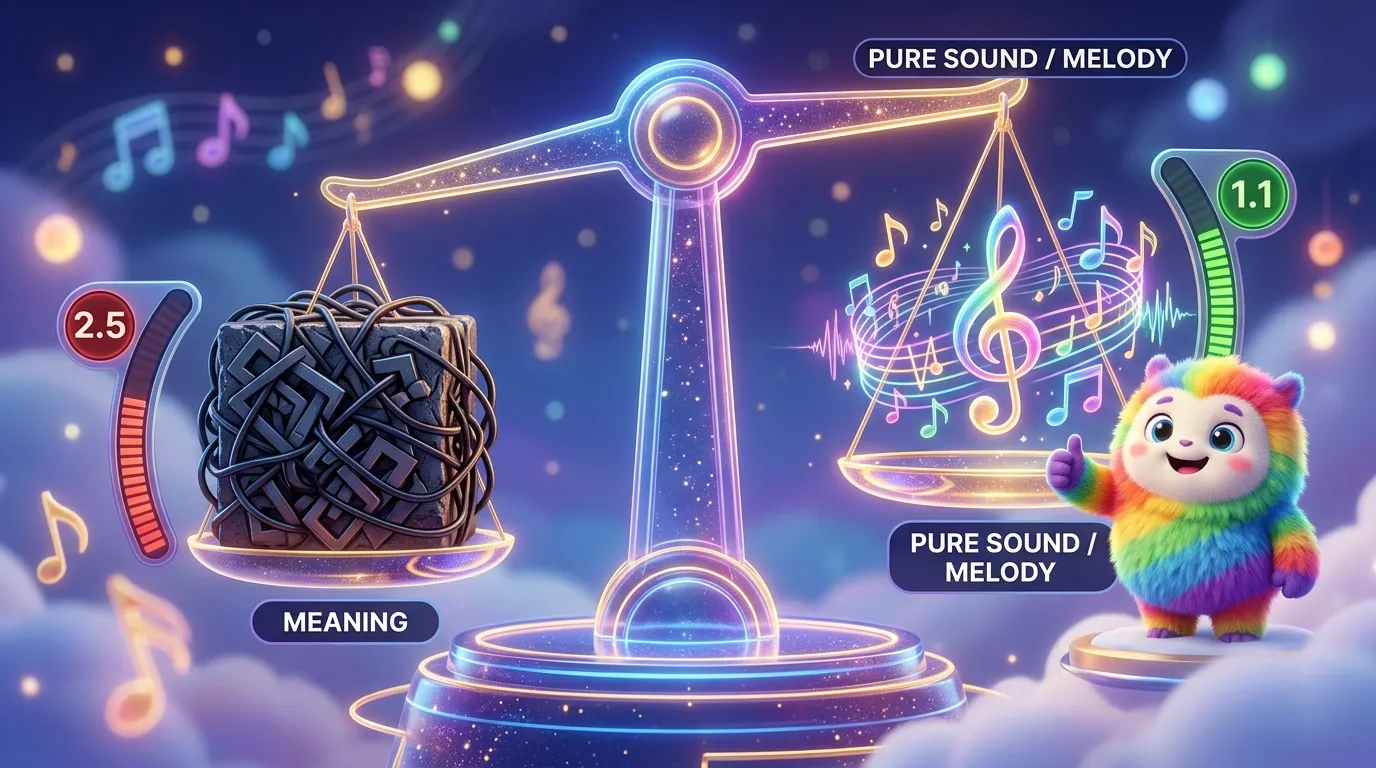
最初は「英語としても意味が通る歌詞」を目指していたのですが、実際に距離を測ってみると差は歴然でした。
- 意味を残そうとした案 … 距離 2.5以上
- 音だけに振り切った案 … 距離 1.1
同じフレーズでこれだけ差が出ます。空耳としての完成度は、意味を捨てたほうが圧倒的に高いことが数字で確認できたので、以降は音優先に方針を固定しました。
4. 使う単語のルールを決める
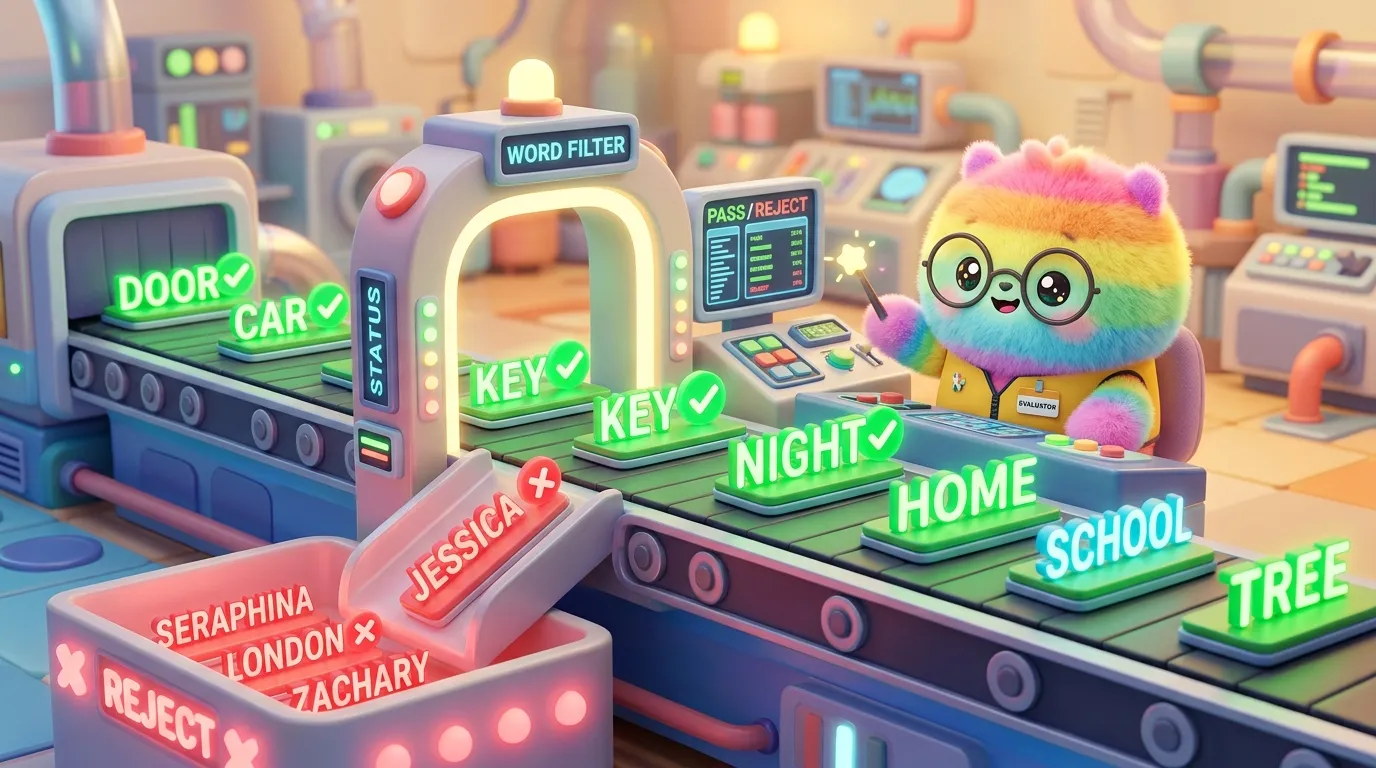
ビームサーチは放っておくと、Gogh(ゴッホ)や Honda、Kim Tom Joe のような固有名詞や人名を大量に出してきます。音としては合っていても、固有名詞に頼ってしまうと「誰でも作れる安易な空耳」になりますし、聞き手としても「それどういう意味の単語?」と引っかかって、作品としての工夫や面白さが感じられなくなってしまいます。
そこでルールを決めて、機械的に除外することにしました。
- 固有名詞・人名・敬称は使わない
- 綴りが特殊な単語、意味の通らない謎のトークンは使わない
- 中学校レベルの、誰もが知っている一般的な単語だけで構成する(
coatallwearmoreknockhereyoucarkeymydarkknowsheなど)
除外した音は、同じ音で始まる普通名詞や動詞で置き換えます(Kim→Key man、Joe→Jaw、Tom→Tomb)。
5. 長いフレーズは節に分割して探索する
13〜15音素を超える長いフレーズをそのままビームサーチに渡すと、探索空間が爆発して数十秒以上返ってきません。
対策は単純で、「こちらの仕事に / 文句ばかり」のように4〜8音素程度の自然な節に切ってから探索します。数秒で終わるようになっただけでなく、単語の境界がはっきりするので結果の質そのものが上がりました。速くするための工夫が精度も上げた、珍しいパターンです。
6. 作曲・映像・合成から投稿までをパイプラインにする
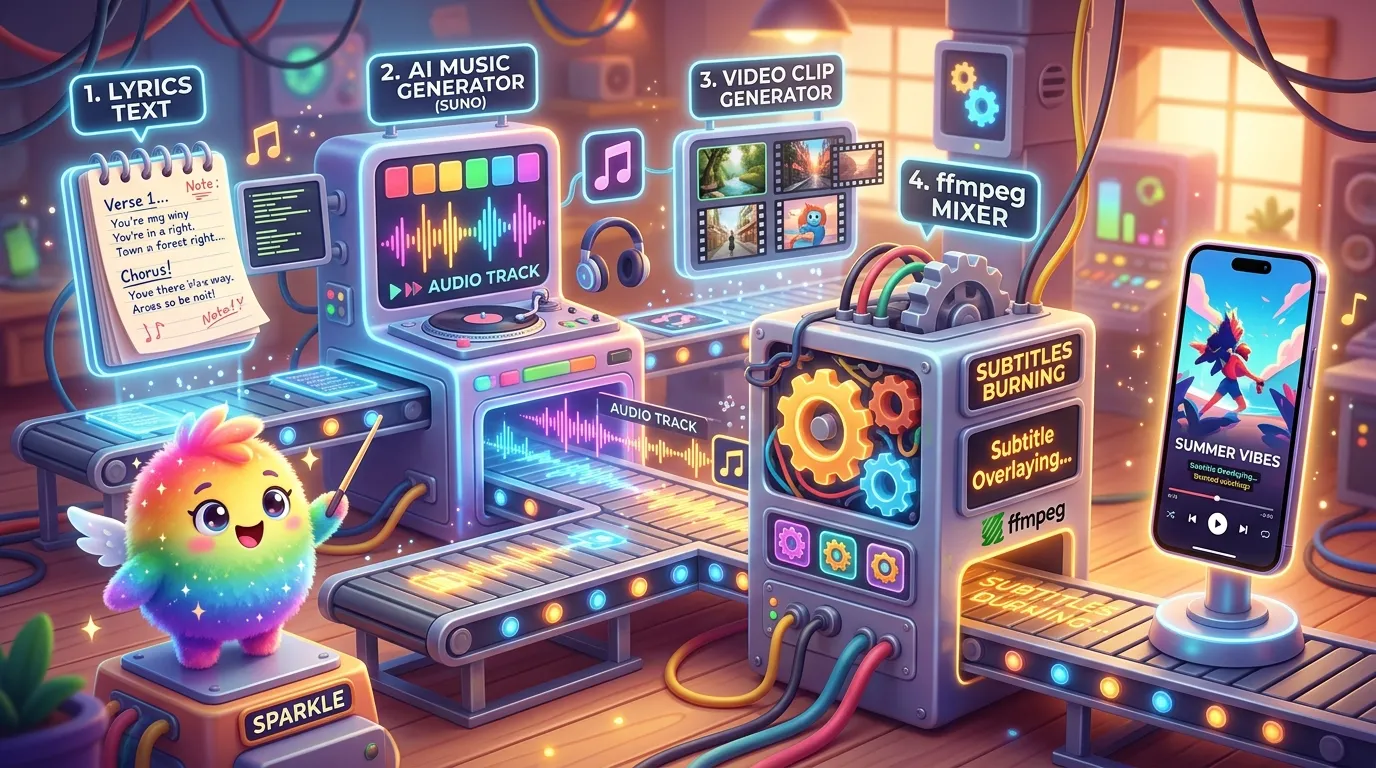
歌詞が決まったあとの工程もスクリプトと連携でまとめました。
- 歌詞とスタイル指定を整形して出力し、作曲AI(Suno)に投入する
- 確定した歌詞から、カットごとの映像プロンプトを生成する
- 生成した動画クリップを ffmpeg で連結し、元音声をミュートして曲を乗せ、字幕を焼き込んで縦型9:16で書き出す
- サムネイルを生成し、Claude Code の拡張機能経由で YouTube へ自動投稿する
カットの尺は --clip-durations 5.0 5.0 7.0 8.0 のように1カットずつ指定できるようにしました。素材の秒数のまま繋ぐと、最後のカットが1秒で強制終了する事故が起きるためです。カット間には0.5秒のクロスフェードを入れると、繋がりが一気に自然になります。
YouTube への投稿も Claude Code 経由で全自動化
動画ファイルが完成した後の YouTube 投稿は、YouTube Data API を使わずに Claude Code の拡張機能経由 で実施しています。API だと認証トークンの有効期限切れやクォータ制限、複雑なパラメータ定義の手間がありますが、拡張機能を介してブラウザ操作・アップロードを一貫して自動化しました。
単に動画ファイルをアップロードするだけでなく、実運用で必要になる以下の作業をすべて自動で完了させています。
- サムネイルの自動設定: Pillow で生成した統一フォーマットのサムネイル画像を自動適用
- シリーズ化(再生リストへの追加): 既存の「空耳シリーズ」再生リストへ自動で紐付け
- 予約投稿の設定: 最適な公開タイミング(翌朝など)へのスケジュール予約
- タイトル・説明欄・タグの反映: 歌詞や曲の情報をテンプレートから自動流し込み
手動で YouTube Studio を開き、毎回マウスでポチポチ設定する必要が一切なくなり、動画生成から予約投稿までが完全に一気通貫しました。
7. キャラクターは「設計図」を先に作る
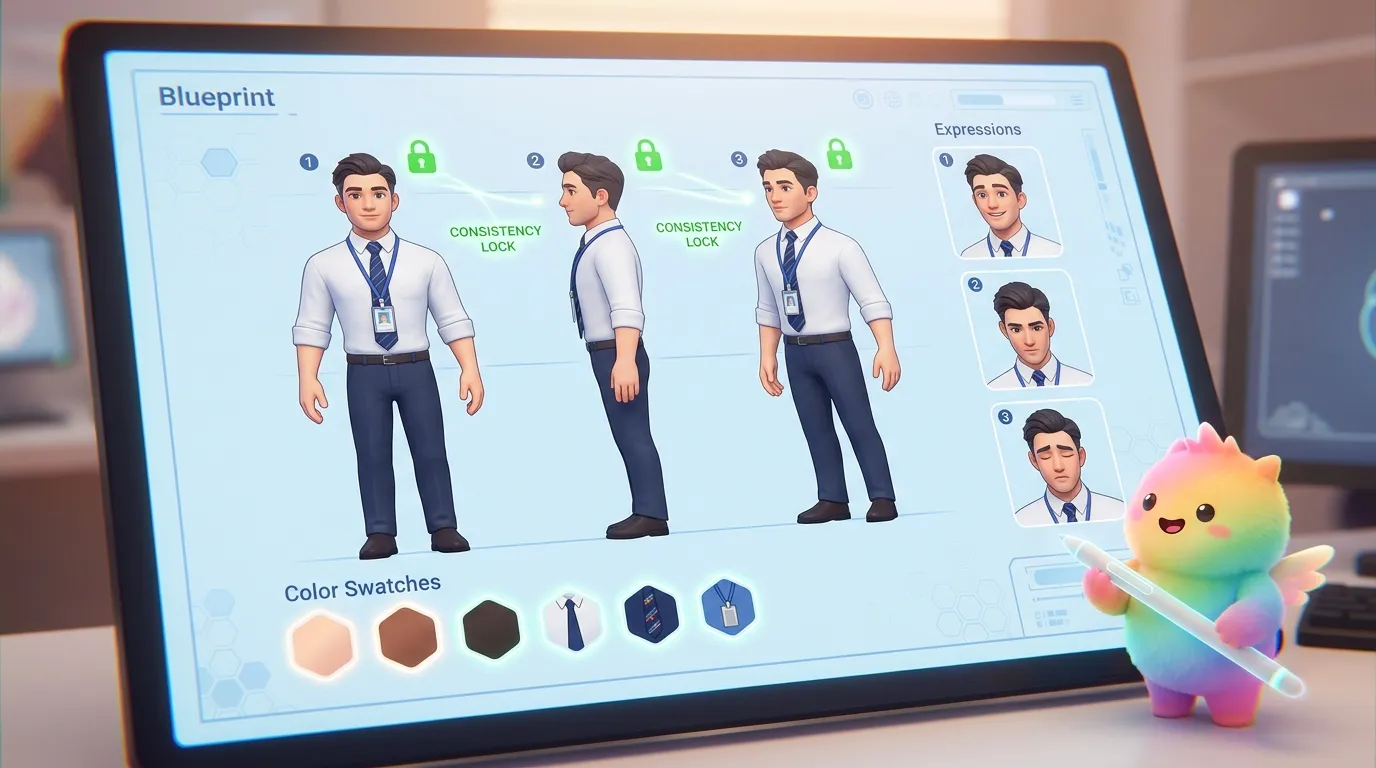
映像生成でいちばん困ったのが、プロンプトを投げるたびに登場人物が別人になることです。同じ「疲れた30代の男性社員」と書いても、髪型も服も年齢感も毎回変わります。4カットつないだ動画で人物が入れ替わったら、それだけで作品として破綻します。
対策は、プロンプトを工夫することではなく、先にキャラクターの設計図を作って、それを読み込ませることでした。
具体的には、キャラクターごとに次の項目を文章で固定します。
- 年齢・立場(30代、万年ヒラ社員)
- 性格(気が利かない・内気・気弱)
- 顔まわり(半目で疲れた顔)
- 服装を全部(白ワイシャツ、紺ストライプのネクタイ、紺の下げ紐に社員証、グレーのスラックス)
- 背景(無地の白で統一)
ここまで書いて初めて、別のカットでも同じ人物として出てきます。逆に1つでも書き漏らすと、そこが毎回変わります。
登場人物は増やしすぎないほうが管理しやすいので、「愚痴る本人」「理不尽な上司」「やらかす後輩」といった役割ベースで数人に絞り、設定はスプレッドシートで一元管理しています。キャラクターを資産として持つ、という発想に切り替えたのが転換点でした。
チェックの仕組み紹介
この仕組みで一番学びが大きかったのは、「機械のスコアをどこまで信じるか」でした。
1. Whisperで「聞こえるか」を機械的に足切りする
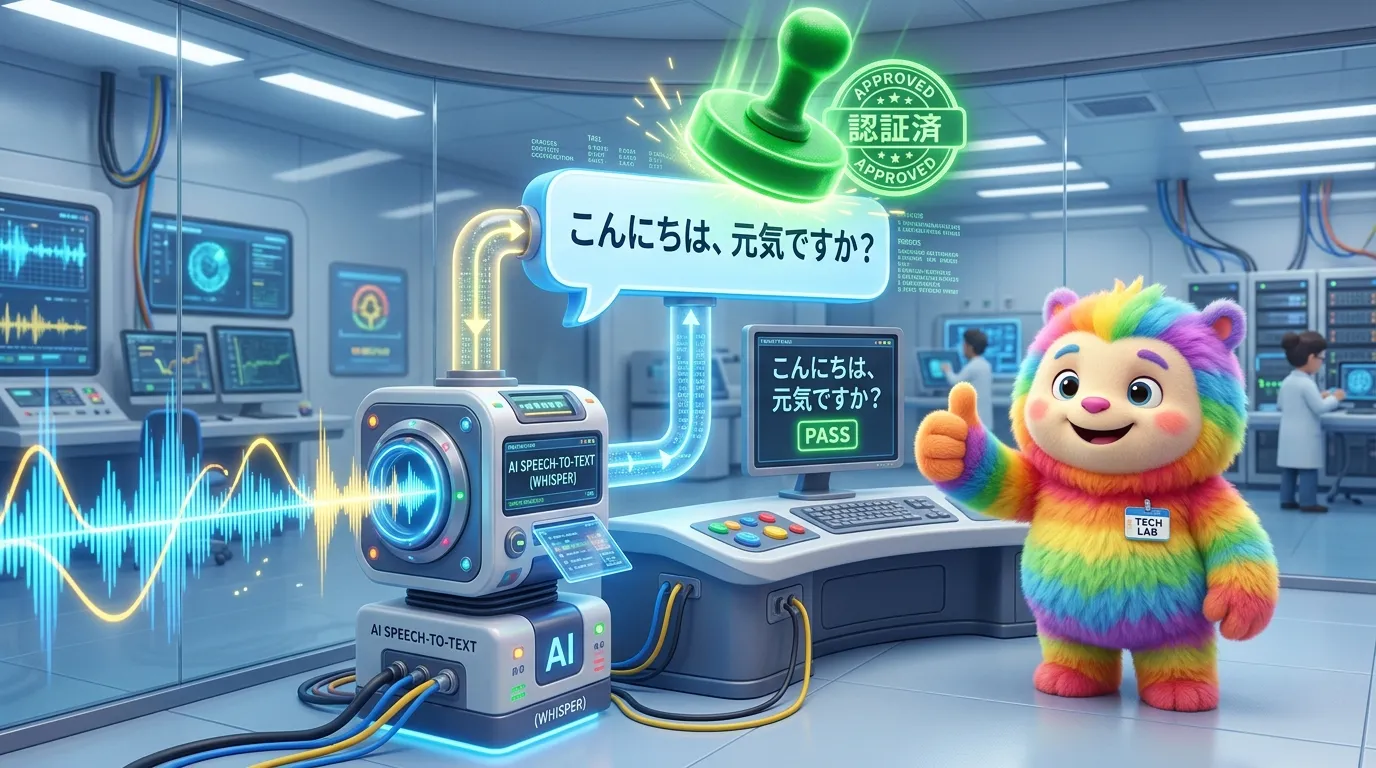
できあがった曲を人間が全部聴いて選ぶのは大変です。そこで、合成前の音源を音声認識(Whisper)に日本語モードで強制的に文字起こしさせ、狙った愚痴フレーズがどれだけ復元されるかを距離で評価しています。
Whisperが日本語として「なんかムカつく」に近い文字列を返せば、それは人間の耳にもそう聞こえる可能性が高い、という考え方です。これで明らかに聞こえないテイクを試聴前に落とせるようになりました。
2. 距離スコアは語尾のR/Tを過大に減点する
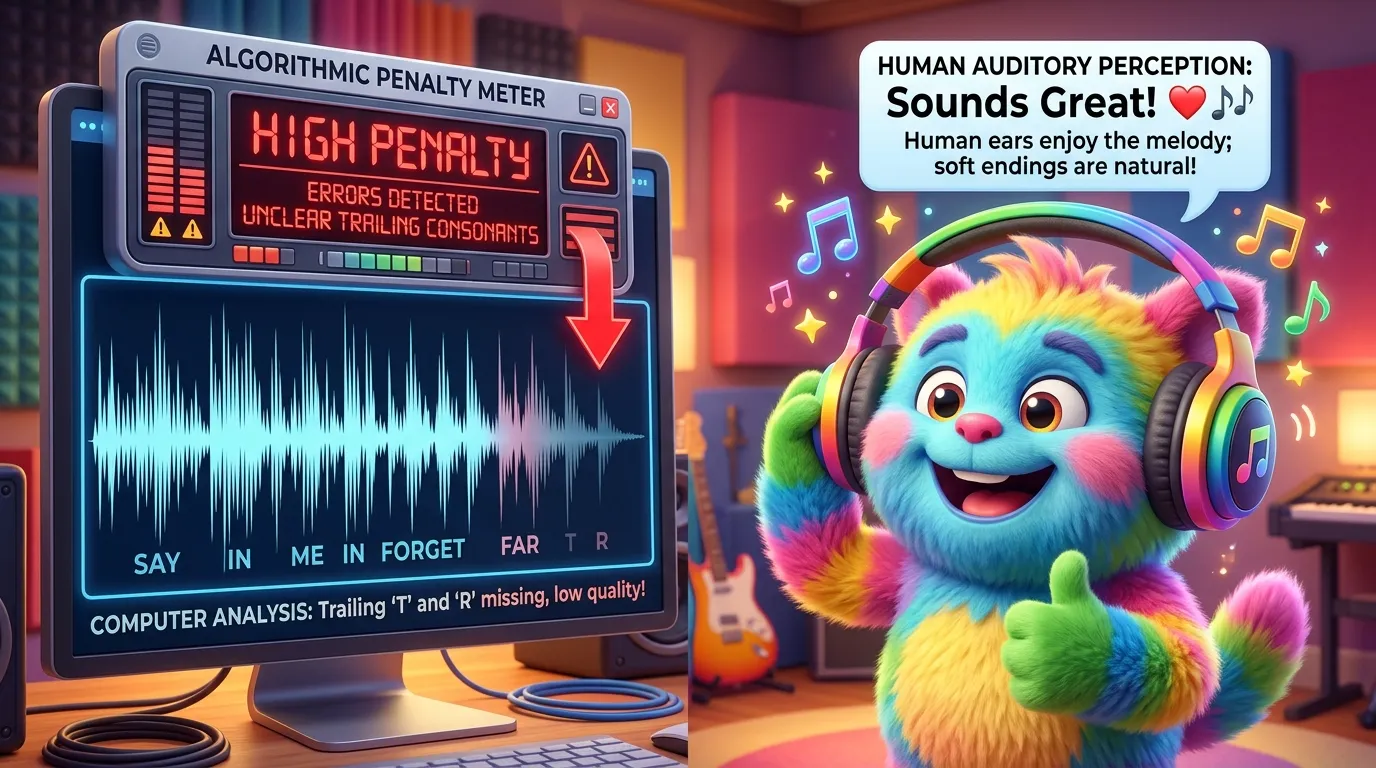
一方で、距離スコアを信じすぎると失敗します。同じフレーズの2案を採点したとき、こうなりました。
| 英語案 | 距離 |
|---|---|
| A案 | 0.00 |
| B案 | 3.05 |
数字だけ見るとB案は「かなり崩れている」判定です。ところが実際に歌わせたらB案のほうが空耳として成立していて、そちらを採用しました。
理由は、heart = HH AA R T、night = N AA IY T のように英単語の末尾に来る R や T を、モデルが「余分な音素」として重く減点しているためです。しかし歌になると語尾の子音はほとんど聞こえません。人間の耳には存在しない音に、モデルだけがペナルティを払っていたわけです。
結論として、距離スコアは「候補を絞る道具」であって「正解を決める道具」ではないと割り切りました。機械で数百候補を数十候補に落とし、そこから先は自分の耳で決めています。
得られたメリット
一晩かかっていた作業が数秒になった
空耳候補を探す作業がスクリプト1回で終わるようになりました。しかも人間では思いつかない組み合わせが出てきます。
品質の基準を数字で議論できるようになった
「意味を残すか、音を優先するか」のような方針を、感覚ではなく距離という数字で比較できるようになりました。方針を決めるときの迷いが減りました。
ノウハウが積み上がるようになった
制作中に分かったこと(使ってはいけない単語、スタイル指定のクセ、ffmpegの不具合など)を1つの引き継ぎドキュメントに集約し、AIアシスタントが変わっても同じ失敗を繰り返さないようにしました。作業そのものより、この「知見の置き場所を決める」ほうが効果が大きかったです。
使ったサービス・ツール
この動画1本に、けっこうな数のサービスが乗っています。どれが何を担当しているかを整理しておきます。
| サービス/ツール | 役割 | 使ってみての学び |
|---|---|---|
| Python + CMU発音辞書 | 空耳候補の探索 | 発音辞書が公開されているおかげで、音韻の比較を自前で書ける |
| Suno | 作曲 | スタイル指定の書き方で空耳の聞こえ方が激変する。「ほぼ喋り」に寄せると空耳は保たれるが音楽感は減る |
| Google Flow(Veo) | 映像の生成 | テキストから直接動画ではなく、画像を生成してからAnimate指示を出す2段階。ここを知らないと「画像しか出ない」と誤解する |
| Gemini(画像生成) | キャラクター素材の量産 | 一貫した絵柄を保つには、髪型・服装まで文章で固定する必要がある |
| Whisper | 空耳が成立しているかの機械判定 | 日本語モードを強制すると「日本語耳で聞いた結果」に近いものが得られる |
| ffmpeg | 連結・ミュート・音の差し替え・字幕焼き込み | カットごとの採用秒数を指定できるようにしないと末尾が切れる |
| Pillow | サムネイル生成 | 文字数とフォントサイズの規則を決めておくと、毎回同じ体裁で出せる |
| Claude Code(拡張機能) | YouTube投稿・予約の全自動化 | APIを使わず拡張機能経由でブラウザ操作。サムネイル付与、シリーズ化(再生リスト追加)、予約投稿まで自動完結 |
まとめ
音韻の探索という、一見コンピュータが得意そうな領域でも、最後の判定は人間の耳でないと決まりません。逆に言えば、機械にやらせるべきは「正解を出すこと」ではなく「人間が判断できる数まで候補を絞ること」でした。
このパターンは空耳に限らず、候補が爆発するタイプの作業ならどこでも使えると思います。全部を自動化しようとせず、どこまでを機械の担当にするかを決めるのが設計の肝でした。